


サービス概要
GPUaaSプラン紹介
NVIDIA A100
提供単位 1 GPU
NVIDIA A100 GPU × AI/GPUコントローラーをバンドル。
GPUは専有リソース。
NVIDIA B300
提供単位 1 GPU
NVIDIA B300 GPU × AI/GPUコントローラーをバンドル。
GPUは専有リソース。
AI開発の、はじめの一歩を軽くする
GPUaaSなら、NVIDIA製GPUを1枚単位で提供するため、大きな初期投資なしにスモールスタートできます。AIモデルの学習・デプロイ・監視までをまとめてサポートし、GPUaaSポータルにログインするだけで、GPUリソースの管理からAI開発まですぐに開始。Smart Data Platform上のプライベートクラウドとして提供するため、機密データを扱う社内AI基盤としても安心してご利用いただけます。
小さく試し、成果が出たら広げる。AI内製化を現実的なステップで進めるための基盤です。
特長011GPUから始められる
大きな初期投資は必要ありません。
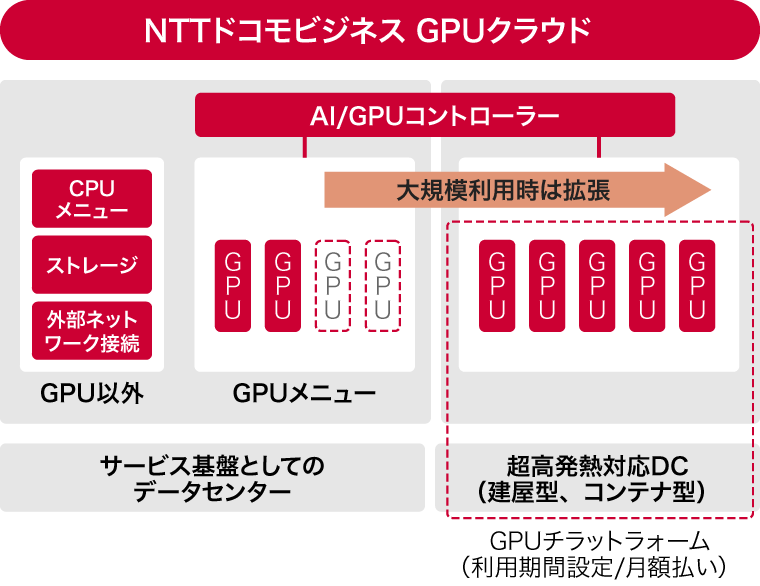
GPUを初期投資なくすぐに利用したいお客さま向けにNVIDIA製GPUを1枚単位で提供。大きな初期投資なしに、短期間でご利用を開始できます。
まずは小さく試し、成果が見えてから必要な分だけ増やす。そんな進め方が可能です。
また、クラスタ構成を組むような大規模なGPU環境を利用したいお客さまは弊社が提供しているカスタマイズ型のGPUプラットフォームへ拡張いただくことが可能です。
特長02AI開発に必要な環境がそろっている
GPUを用意したあとの手間を、まるごと引き受けます。
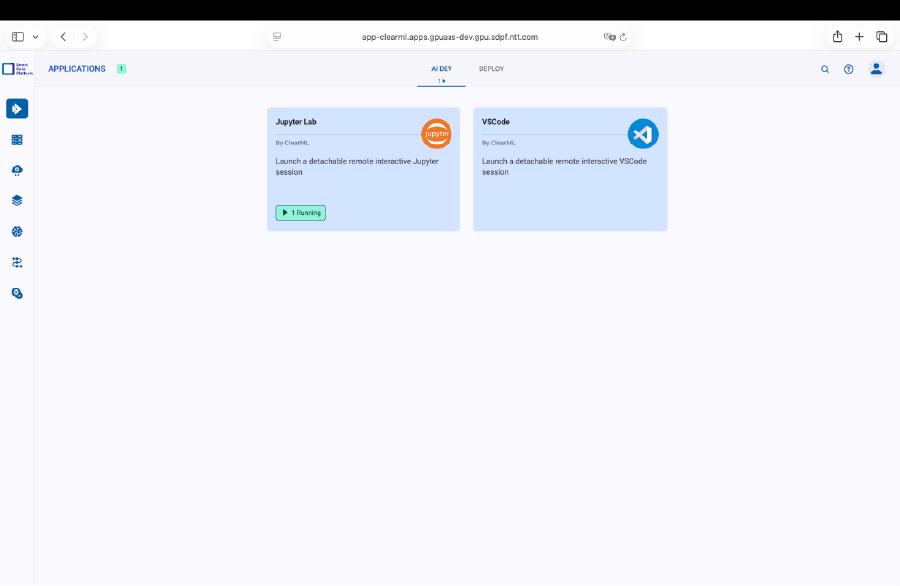
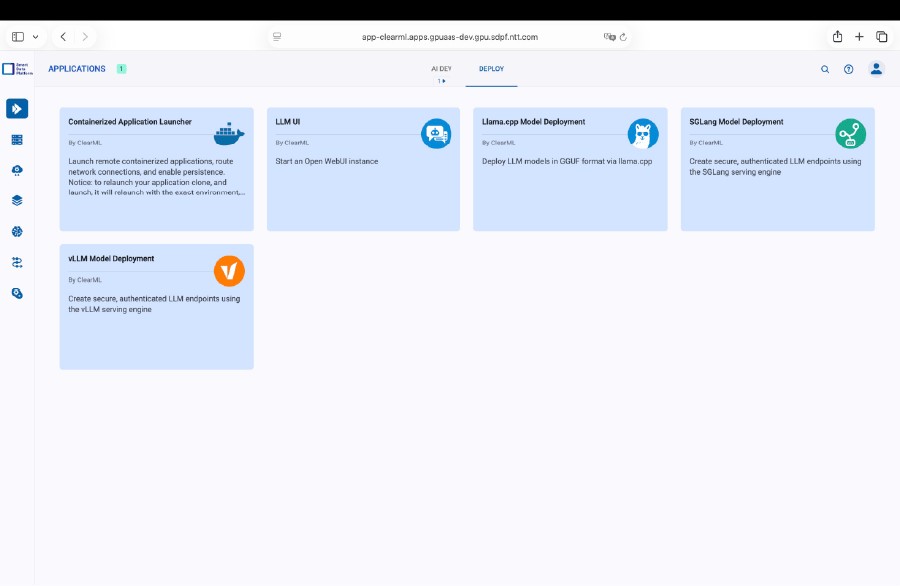
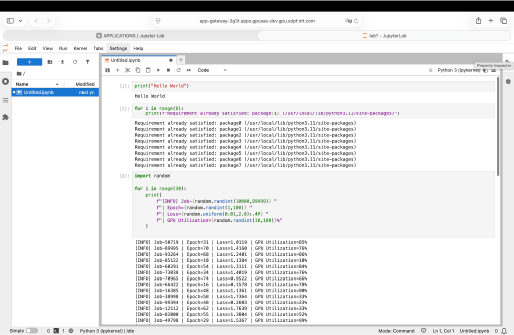
AI開発、LLMをすぐに利用したいお客さまに最適な環境をご提供。GPUaaSポータルにログインするだけで、JupyterLab / VSCode による開発環境をすぐに利用可能。
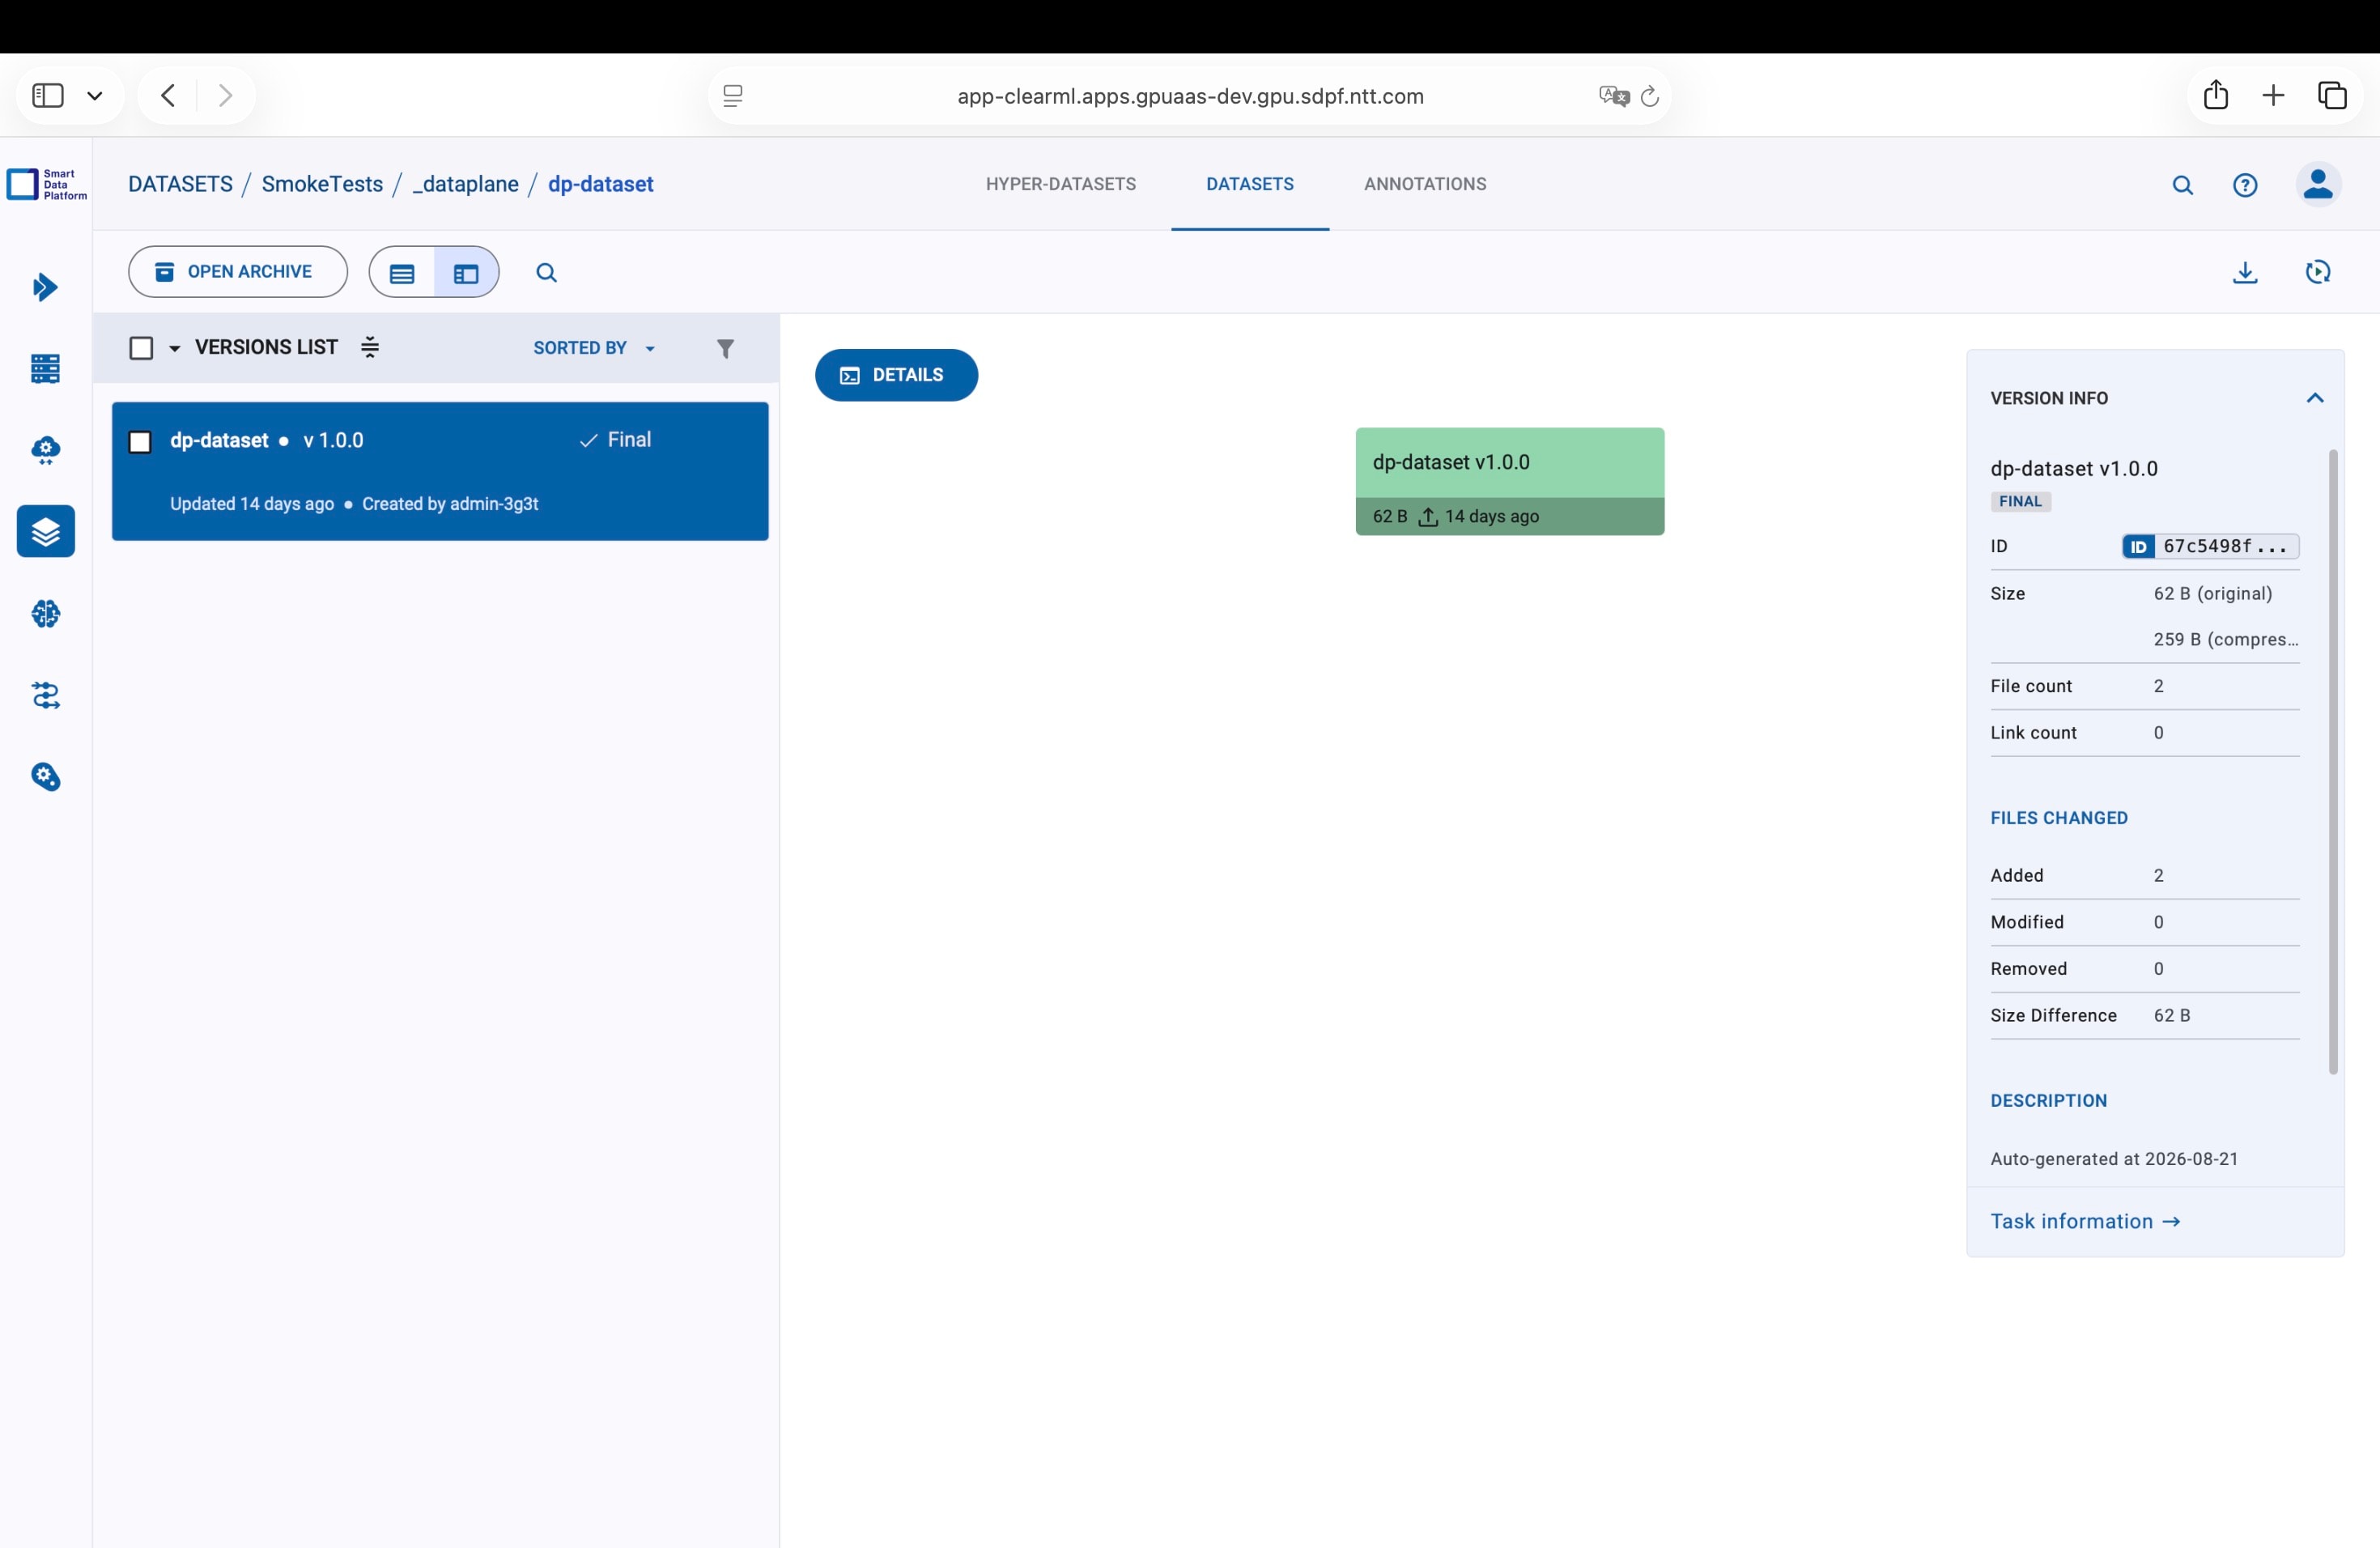
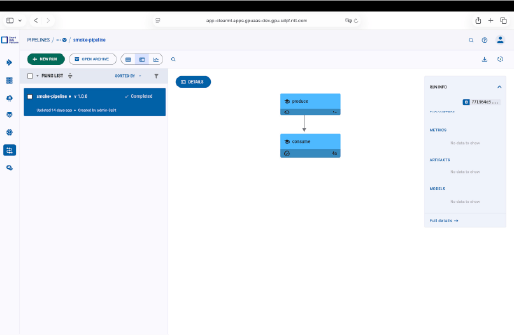
データセットの管理、学習ジョブの実行と追跡、モデルの登録・管理までをひとつの画面で完結できます。
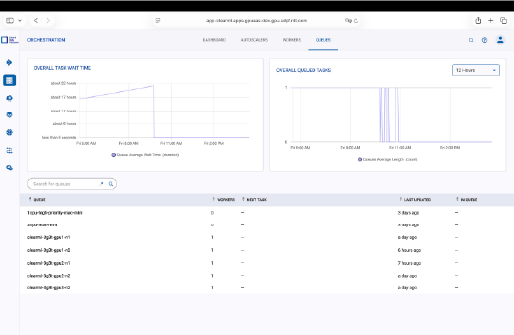
GPUの使用状況は1枚単位で可視化され、部門やチームごとの割り当て、重要なジョブへの優先配分も自在。
リソース管理にかかる手間とコストを抑えられます。
特長03機密データも、安心して活かせる
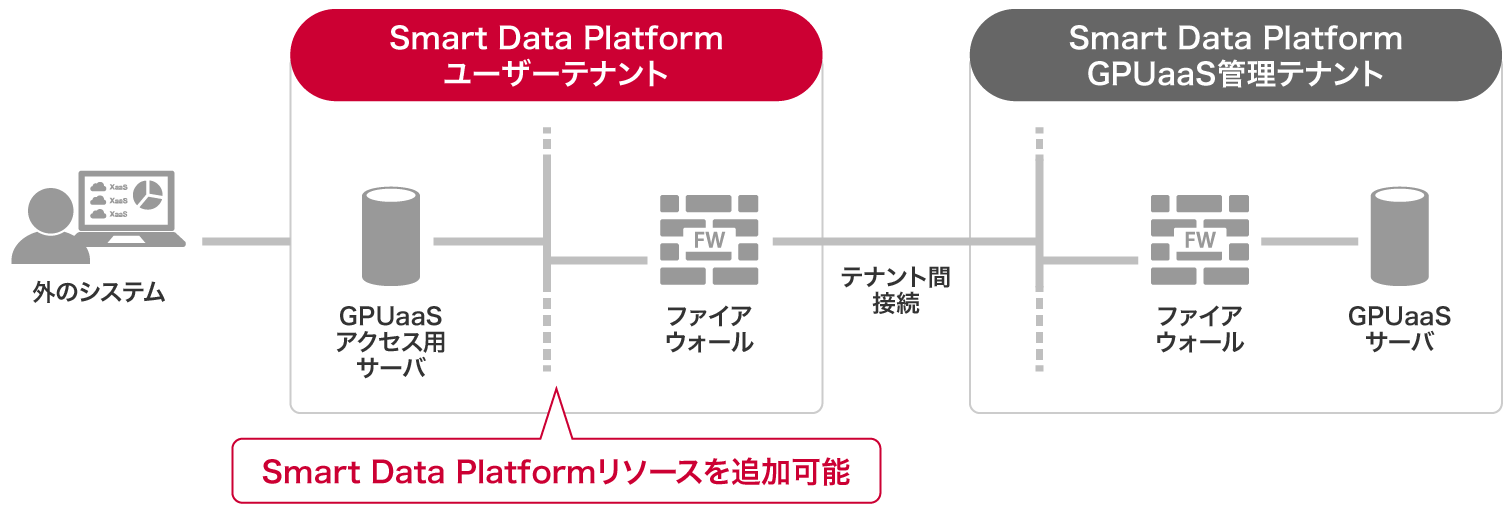
社内に置けるAI基盤だから、扱えるデータが違います。
Smart Data Platform上のプライベートクラウドとして提供し、社内システムとの閉域接続に対応。社内規程やマニュアル、顧客データといった機密性の高い情報を使ったモデル開発も安心して進められます。
さらに、SDPFの各種メニューを組み合わせて構成を拡張したり、大規模利用のフェーズではお客さま専有型の GPUプラットフォーム へスケールアウトすることも可能です。
特長04使い方に合わせて、トータルコストを最適化
従量課金
利用時間・GPU使用量に応じて課金されるため、利用が増えるほど料金も増加します。
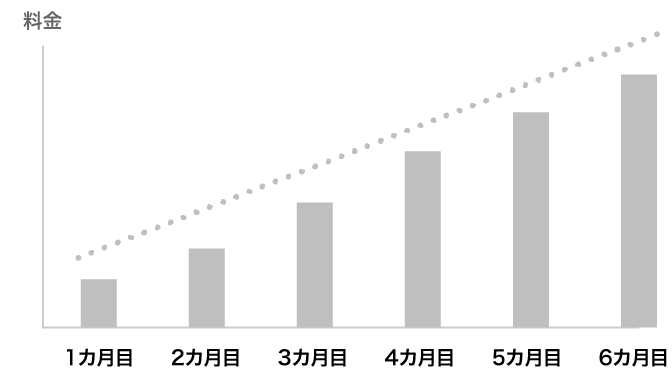
特長
- 使った分だけ支払うため、無駄がない
- 利用が増えると料金が大きく上がる可能性がある
- コストの予測が立てにくい
月額固定(GPUaaS)
利用量にかかわらず月額固定料金なので、コストの予測がしやすく、使い放題で利用できます。
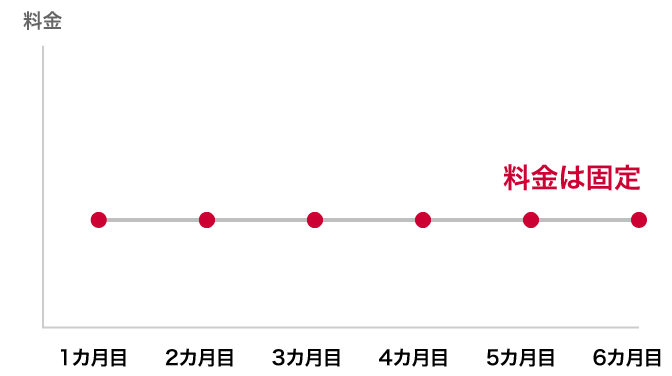
特長
- 月額固定で、コストの予測が立てやすい
- 利用が増えても料金は変わらず、安心して使える
- 長期的・大規模な利用ほどお得になる
「使った分だけ」が、いつも最適とはかぎりません。
従量課金型のクラウドは手軽に始められる一方、利用が長期化・大規模化すると費用が読みづらく、コストが膨らみがちです。
GPUaaSは月額固定料金のため、小さく始める段階から予算が立てやすいのが特長です。さらに利用が拡大したフェーズでは、利用期間設定型・お客さま専有型の GPUプラットフォーム を組み合わせることで、リーズナブルにスケールアウトできます。
PoCから本格運用まで、フェーズごとに最適な形を選べる。だから、AIインフラのトータルコストを長い目で最適化できます。
特長/メリット
サービスの提供範囲と構成
GPUaaS は、SDPF のクラウド / サーバー基盤上に構築した GPU サーバーと AI/GPU コントローラーをお客様テナント経由で利用可能なサービスです。
GPUリソースを1枚単位で払い出し、AIモデルのトレーニングからデプロイ、監視までを一貫して支える AI開発・運用プラットフォームとして利用できます。
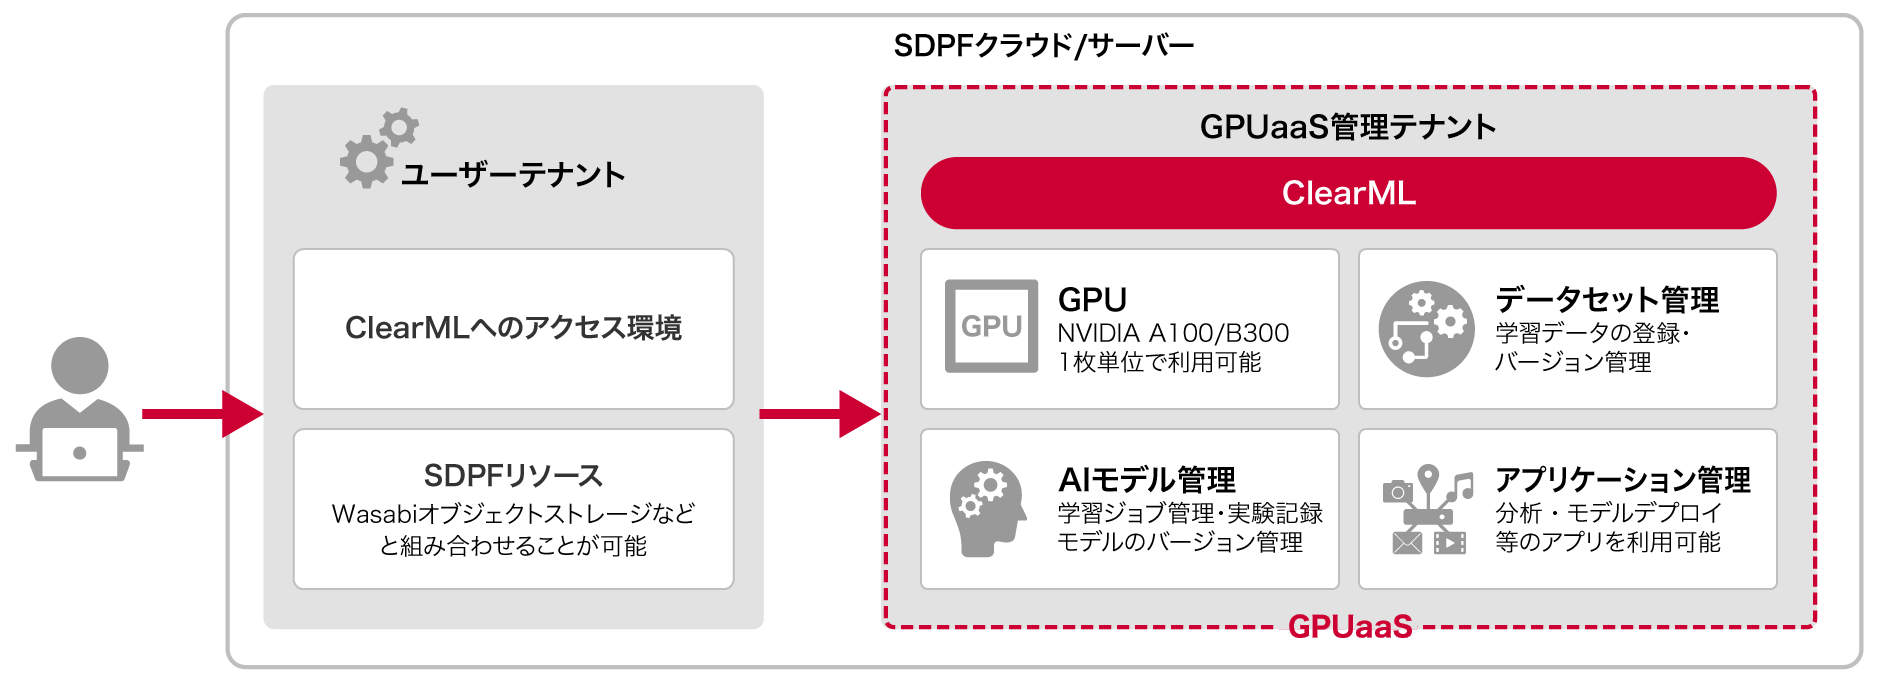
- ■ GPUリソース
- NVIDIA A100/NVIDIA B300を搭載したGPUサーバーを、1枚単位でお客さまテナントへ割り当て。必要な分だけ確保できます。
- ■ AI/GPUコントローラー
- WebGUIにログインするだけで、GPUコントローラー機能とML/AI開発機能を利用可能。GPUの割り当て・可視化から、データセット管理、学習ジョブの実行・追跡、モデルの登録・管理までを一画面で完結します。(※ClearMLの機能を利用して提供)
- ■ セキュリティ
- Smart Data Platform 上のプライベートクラウドとして提供し、社内システムとの閉域接続に対応。機密性の高いデータを外に出さずにモデル開発を進められます。
- ■ 提供範囲
- GPUサーバーからAI/GPUコントローラーまでを当社が提供。お客さまはアクセス環境をご用意いただくだけで、環境構築の手間なく開発を始められます。
サービス仕様
| 提供形態 | マルチテナント型 |
|---|---|
| 提供内容 | 1GPU単位で提供/AI開発環境までサービスとして提供 |
| ご利用料金 | 月額固定金額(日割りあり) |
| 提供リードタイム | お申込受領より5営業日 |
| 最低利用期間 | 開通案内通知翌営業日から1日 |
※大規模利用にはお客さま専有型の「GPUプラットフォーム」もご検討ください。
ユースケース
GPUaaSは、はじめてのAI開発から社内向けAIの内製化まで、スモールスタートが必要な場面でご活用いただけます。
CASE1社内データを用いたモデルのファインチューニング
社内規程やマニュアル、問い合わせ履歴といった外部に出しにくいデータを用いて、既存のAIモデルを自社仕様に調整できます。閉域接続に対応したプライベートクラウド上で完結するため、機密性の高い情報も学習に活用できます。
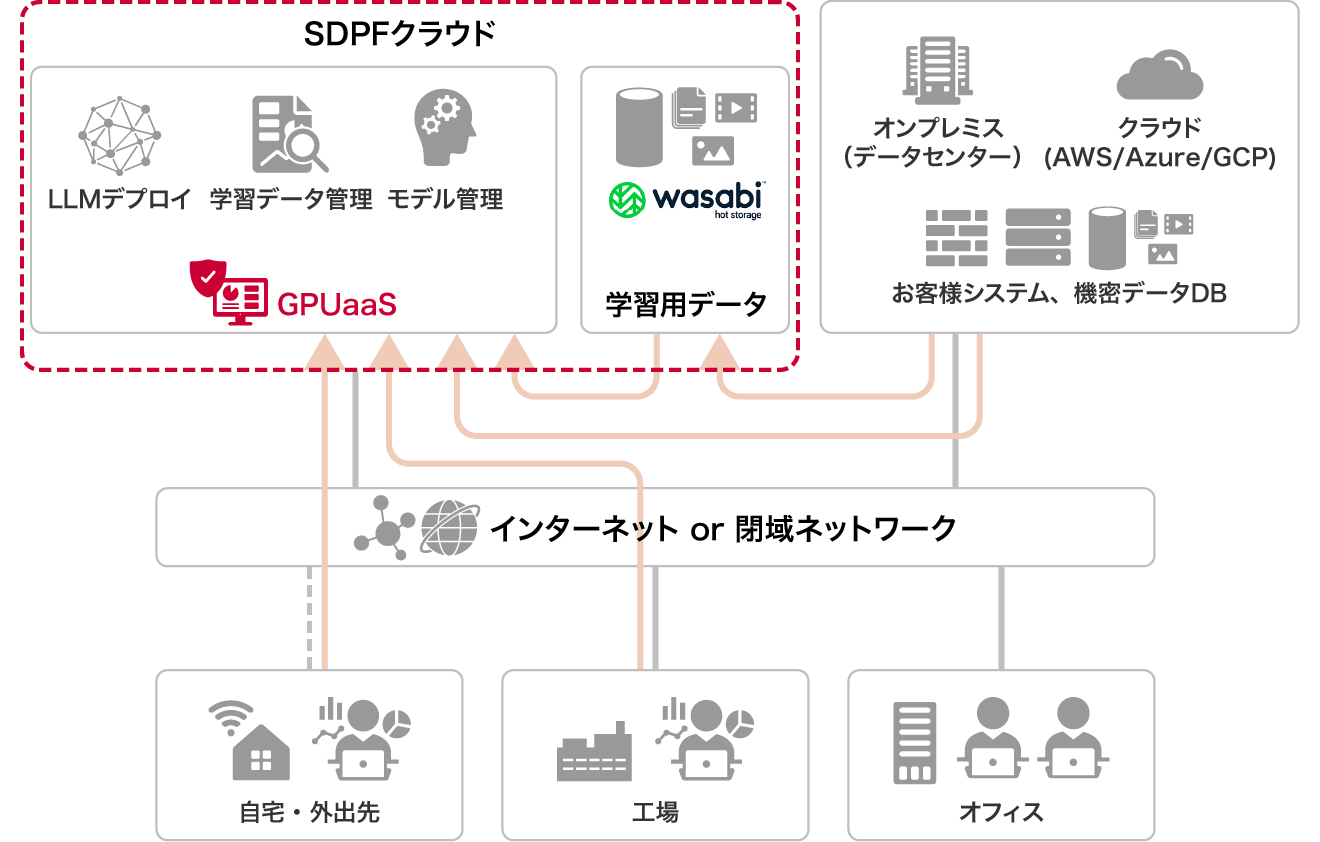
GPUaaS活用のポイント
セキュアな環境ですぐに学習を始められる
- 国内DC活用のクラウド基盤+閉域網でセキュアな環境を提供
- AI開発機能セットでの提供のため、お客様による環境構築不要ですぐにご利用が可能
モデルの学習を一元管理
- 公開されているLLMの読み込みとデプロイが可能
- モデルの学習における実験結果を比較、再現可能
- 学習データを版管理し共有可能
学習済みモデルを用途に応じて活用
- 学習済みモデルは推論エンドポイントとして利用することも、お客様環境へ展開することも可能
CASE2生成AI活用のPoC・技術検証
GPU1枚から始められるため、サーバー単位・年単位の契約を待たずに検証に着手できます。成果が見えた段階で必要な分だけ増やす、段階的な進め方が可能です。
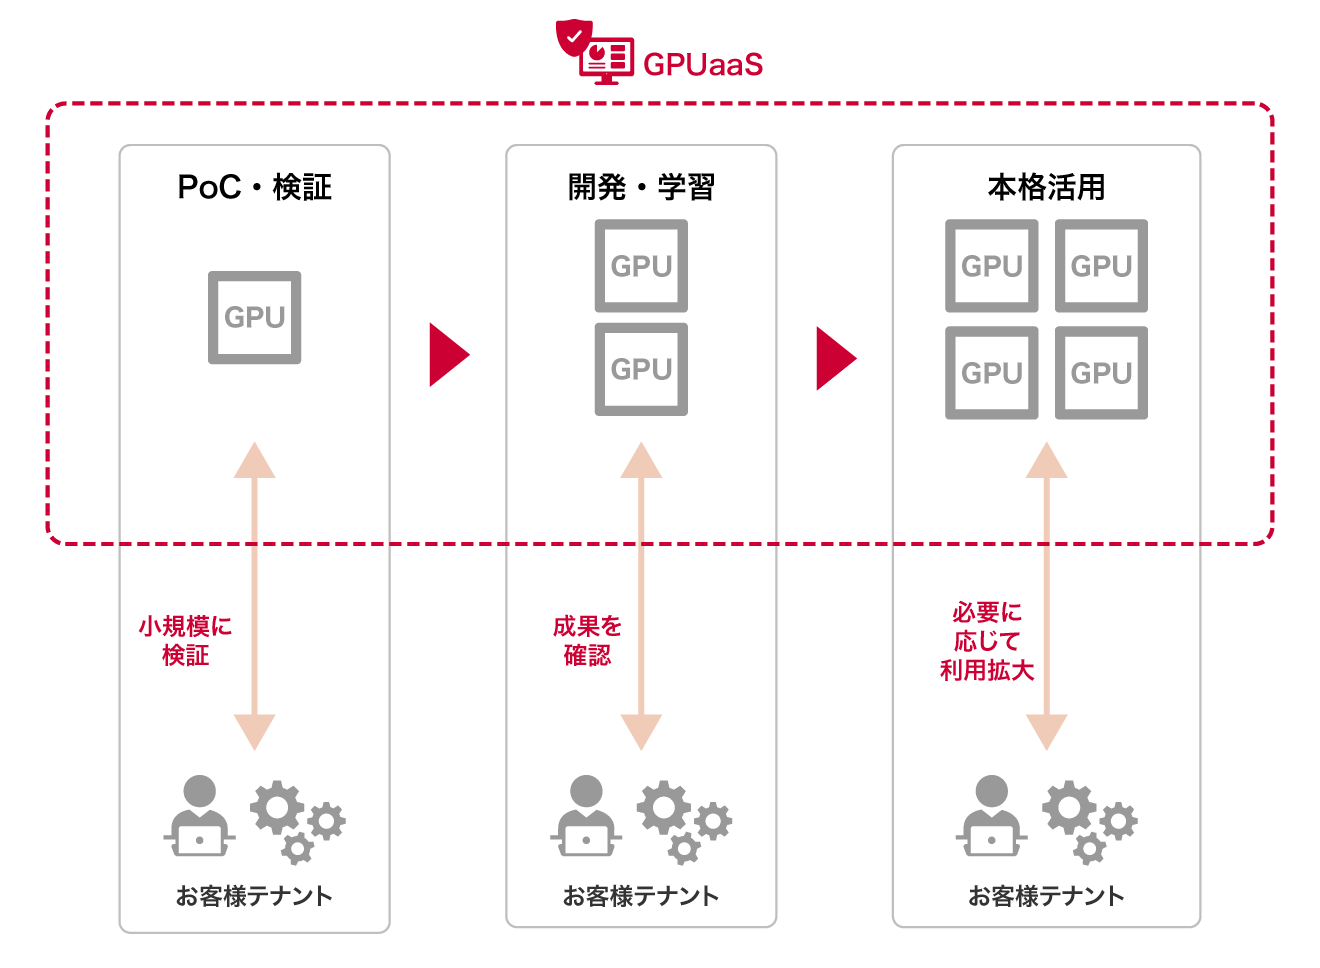
GPUaaS活用のポイント
必要なGPU環境をすぐに利用
- 高性能なGPUリソースを、必要な期間・用途に応じて利用可能
- GPUサーバーを自社で保有することなく、AI開発・検証に活用
AI開発・検証を効率化
- 生成AI・LLMなど、GPUを必要とするAIモデルの開発・検証に活用
- 高性能なGPUリソースを活用し、学習・推論などの処理を効率化
スモールスタートから本格活用へ
- PoCなどの小規模な検証から始め、用途に応じて利用を拡大
- 検証から実運用まで、AI活用のさまざまなフェーズに対応
CASE3自社データと連携した業務エージェントの利用
GPUaaS上のLLMを業務エージェントから利用し、情報検索・問い合わせ・文書作成を支援することが可能です。
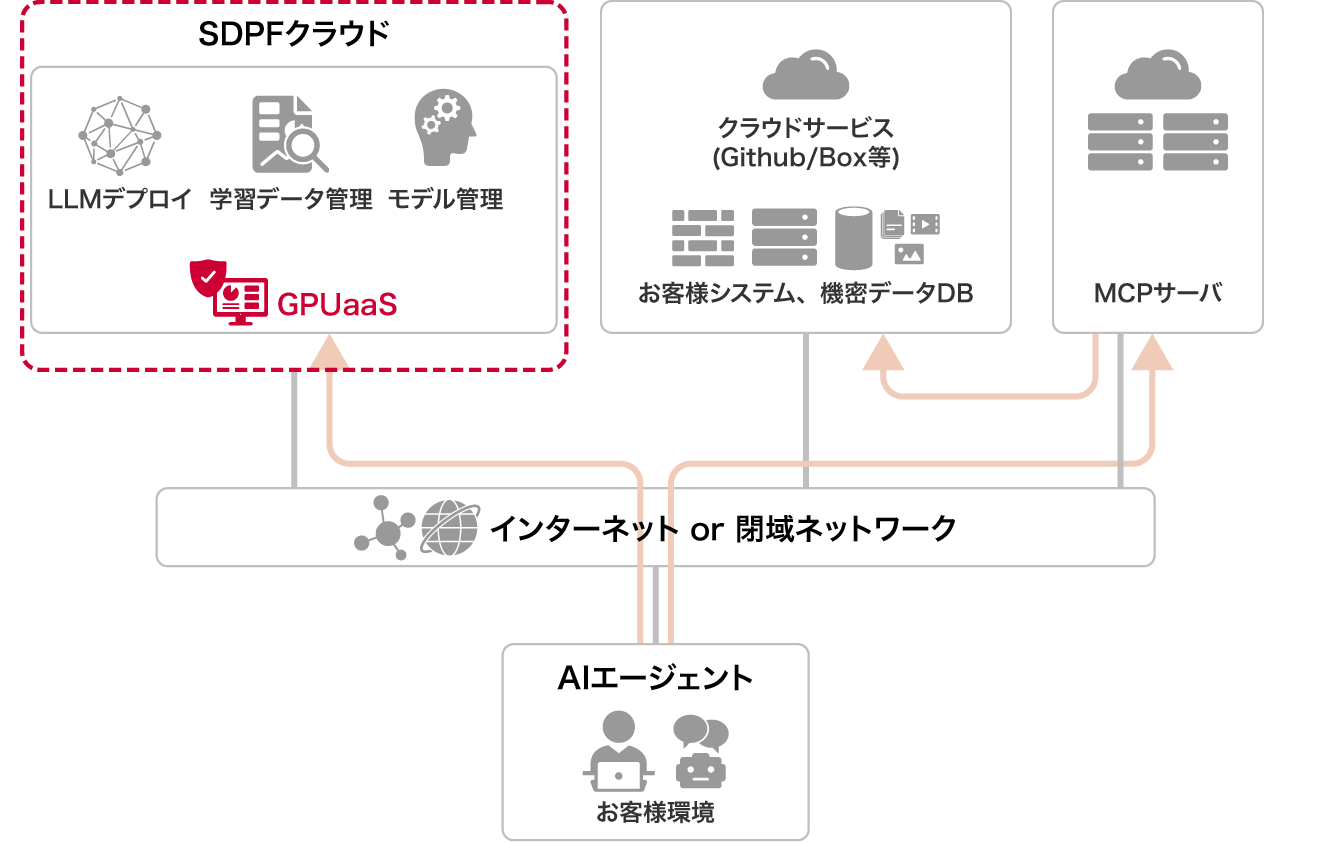
GPUaaS活用のポイント
セキュアなLLM利用
- 国内DC活用のクラウド基盤+閉域網でセキュアな環境を提供
- NaaSサービス(docomo business RINK® WANセキュリティ)を併用し、NWとしての柔軟性・セキュリティの向上も可能
お客様既存環境との連携
- お客様環境のエージェントからGPUaaS上のモデルのエンドポイントを利用可能
業務を効率化
- AIエージェントからGPUaaSにてデプロイ、学習させたモデルを利用することで問い合わせ・情報検索・文書作成などの作業を支援
●大規模な学習や常時稼働などの場合は、お客さま専有型の「GPUプラットフォーム」の導入もご相談いただけます。
ご利用までの流れ
お申し込みからご利用開始まで
お申し込みからAI開発まで、かんたん3ステップ!GPU環境の構築は不要。GPUの種類と枚数を選んでお申し込み後、GPUaaSポータルからすぐにAI開発を始められます。
STEP1 GPUを選んで申し込む
閉じる
ご利用になるGPUの種別と枚数を選択してお申し込みください。お申し込み後、テナント管理アカウントと接続情報をお渡しします。
※ご利用にあたっては、Smart Data Platformのユーザーテナントのご利用が必要になります

STEP2 利用するメンバーを登録
閉じる
管理者がGPUaaSポータルにログインし、利用するユーザのアカウントを登録。GPUの利用状況や利用ポリシーもポータルから管理できます。

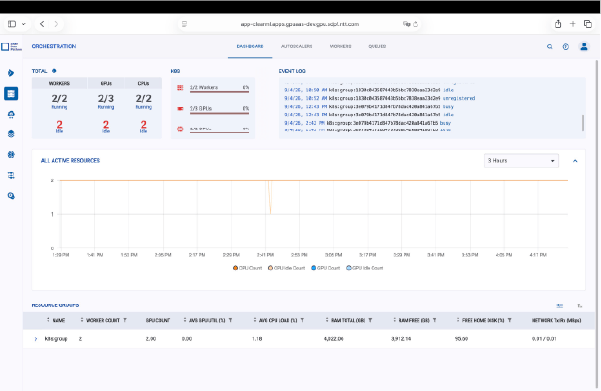
STEP3 GPUを選んでAI開発スタート
閉じる
ユーザーアカウントでGPUaaSポータルにログインし、タスクの実行環境を選択してNotebookを作成します。VSCodeやClearML SDKからの接続にも対応。
データセットを用いて学習ジョブを実行し、作成したモデルはポータル上で登録・管理まで行えます。
※GPUサーバーおよびAI/GPUコントローラーの準備は当社が行うため、お客さまでの環境構築作業は不要です。

GPU環境を一から構築する必要はありません
GPUサーバーやAI/GPUコントローラーなどの基盤はあらかじめ準備されているため、お客さま自身でGPU環境を構築することなく利用を開始できます。
■ GPUaaSポータルでは、以下の環境を一元的に管理できます。
- ユーザーアカウントの作成・管理
- ユーザー/グループ単位のポリシー設定
- 利用上限の設定
- GPU利用状況の確認
- GPUリソースの予約
- ポリシーによる利用制
開発者だけでなく、GPUリソースを管理するIT部門にも使いやすいサービスです
料金
GPUaaSは月額固定料金です。ご利用になるGPUの種別と枚数に応じた月額料金で、初期費用はかかりません。具体的な金額はお問い合わせください。
よくあるご質問
Q GPUaaSとはどのようなサービスですか?
開く
Q GPUaaSとクラウドGPUの違いは何ですか?
開く
Q GPUaaSを利用するメリットは何ですか?
開く
Q GPUサーバーを自社で購入する場合とGPUaaSでは何が違いますか?
開く
Q 一般的なクラウドのGPUサービスとの違いは何ですか?
開く
Q GPUaaSとオンプレミスGPUはどちらを選ぶべきですか?
開く
Q どのような企業・用途にGPUaaSが向いていますか?
開く
Q 生成AIの学習にはどのようなGPU環境が必要ですか?
開く
Q LLMの学習と推論では必要なGPU環境は異なりますか?
開く
Q 生成AIやLLMの学習・推論に利用できますか?
開く
Q AIの推論用途だけでも利用できますか?
開く
Q 機械学習やディープラーニングに利用できますか?
開く
Q シミュレーションやHPC用途にも利用できますか?
開く
Q どのようなGPUを利用できますか?
開く
Q GPUリソースは専有できますか?
開く
Q GPUを専有するメリットは何ですか?
開く
Q 複数のGPUを利用した大規模なAI基盤を構築できますか?
開く
Q GPUの性能を最大限活用するためのネットワーク環境は用意されていますか?
開く
Q GPUだけでなく、サーバー・ストレージ・ネットワークもまとめて提供できますか?
開く
Q 自社拠点や既存システムと接続できますか?
開く
Q 他社クラウドやデータセンターと接続できますか?
開く
Q 機密データを使った生成AIにはどのようなGPU環境が適していますか
開く
Q 機密情報や社内データを扱う生成AIにも利用できますか?
開く
Q インターネットを経由せずにGPU環境へ接続できますか?
開く
Q GPUはどこに設置されますか?国内データセンターを利用できますか?
開く
Q GPU基盤の構築や運用まで任せることはできますか?
開く
Q 障害発生時の保守・サポート体制はどうなっていますか?
開く
Q GPUaaSの料金体系を教えてください。
開く
Q 導入までどのくらいの期間がかかりますか?
開く